Par Axel Legay — Expert en cybersécurité et intelligence artificielle
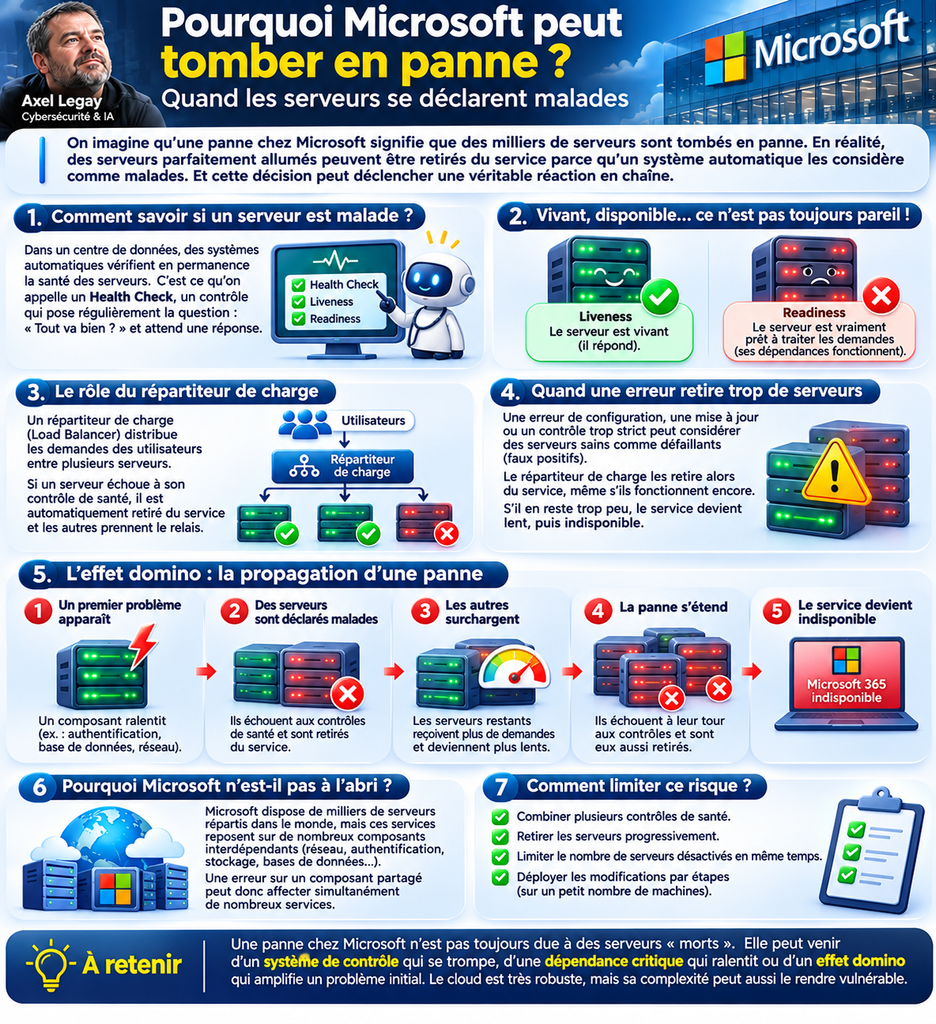
Quand Microsoft 365, Outlook ou Teams tombe en panne, on imagine souvent des serveurs qui s’éteignent brutalement dans un immense centre de données. Pourtant, la réalité est parfois beaucoup plus étonnante. Les serveurs peuvent être parfaitement allumés, les connexions réseau fonctionner et les applications continuer à tourner, sans que les utilisateurs puissent accéder au service.
Pour comprendre ce paradoxe, il faut découvrir un mécanisme essentiel des grandes infrastructures informatiques : le Health Check, autrement dit le contrôle de santé des serveurs. Ce système, conçu pour détecter les machines défaillantes et maintenir les services disponibles, peut parfois contribuer à amplifier une panne lorsqu’il fonctionne mal ou lorsqu’une défaillance se propage.
1. Un serveur peut être vivant, mais malade
Imaginez un restaurant dont les lumières sont allumées, les portes ouvertes et les cuisiniers présents. Pourtant, les clients ne reçoivent aucun repas parce que le système de commandes est bloqué. Le restaurant existe toujours et son personnel travaille, mais il n’est plus capable de rendre correctement le service attendu.
En informatique, c’est exactement la même chose. Un serveur peut être allumé et répondre à certaines requêtes, mais être incapable d’accéder à sa base de données ou de communiquer avec un autre composant indispensable. Il est donc vivant, sans être nécessairement disponible pour les utilisateurs.
C’est pourquoi les grandes plateformes cloud utilisent plusieurs types de contrôles. Le liveness check permet de vérifier qu’un programme fonctionne toujours, tandis que le readiness check cherche à déterminer s’il est réellement prêt à traiter de nouvelles demandes.
2. Comment fonctionne le contrôle de santé ?
À intervalles réguliers, un système automatique interroge les serveurs. Il peut notamment envoyer une requête HTTP vers une adresse technique, par exemple /health, et analyser la réponse obtenue. Un code 200 OK peut indiquer que le contrôle a réussi, tandis qu’une erreur ou une absence de réponse peut signaler un problème.
La difficulté réside dans ce que l’on vérifie réellement. Si le contrôle se contente de demander au serveur s’il répond, il peut manquer une panne de base de données. À l’inverse, si le contrôle dépend de trop nombreux services externes, une défaillance mineure peut conduire à déclarer malade un serveur qui pourrait encore traiter une partie des demandes.
3. Quand un serveur tombe malade, les autres prennent le relais
Dans une infrastructure moderne, plusieurs serveurs peuvent fournir le même service. Un répartiteur de charge, appelé load balancer, distribue les demandes des utilisateurs entre ces différentes machines. Si l’une d’elles ne répond plus correctement à son contrôle de santé, le répartiteur peut arrêter de lui envoyer de nouvelles demandes.
Ce mécanisme permet normalement d’éviter qu’une panne isolée affecte les utilisateurs. Les autres serveurs continuent à fonctionner et absorbent les demandes supplémentaires, à condition de disposer d’une capacité suffisante.
4. Le problème commence lorsque trop de serveurs sont déclarés malades
Imaginons maintenant qu’une mise à jour introduise une erreur dans la configuration des contrôles de santé. Plusieurs serveurs pourtant capables de fonctionner sont soudainement déclarés indisponibles. Le répartiteur de charge les retire progressivement du service, même si leurs composants principaux continuent à fonctionner.
Le nombre de serveurs disponibles diminue alors dangereusement. Ceux qui restent doivent absorber une quantité croissante de demandes, ce qui peut ralentir leurs réponses et provoquer de nouveaux échecs aux contrôles de santé.
5. L’effet domino : comment la panne se propage
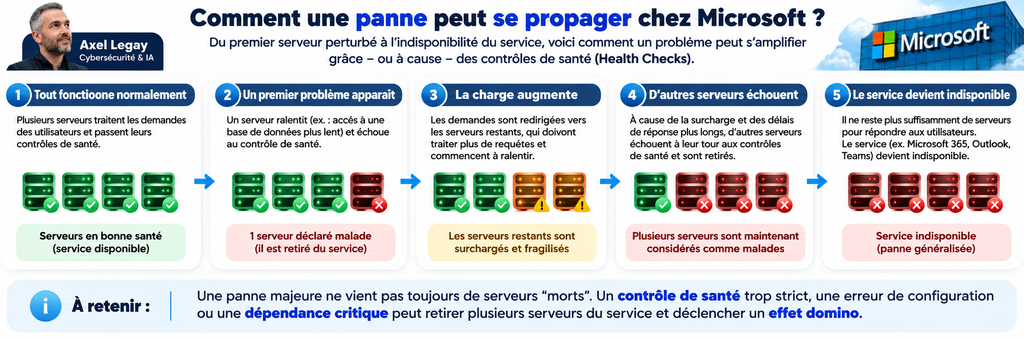
C’est ici qu’une panne relativement limitée peut devenir un incident majeur. Un composant partagé, comme un service d’authentification ou une base de données, commence à ralentir. Plusieurs serveurs dépendant de ce composant ne parviennent plus à répondre correctement aux contrôles de santé et sont retirés de la circulation.
Le trafic est alors redirigé vers les serveurs restants. Leur charge augmente, leurs temps de réponse se dégradent et certains commencent à échouer à leur tour. La capacité disponible diminue encore, ce qui aggrave la surcharge.
On obtient ainsi une réaction en chaîne dans laquelle chaque serveur retiré augmente la pression sur les autres. Dans les cas les plus graves, une grande partie du service devient indisponible alors que de nombreuses machines sont encore physiquement opérationnelles.
6. Pourquoi Microsoft n’est pas à l’abri
Microsoft dispose d’infrastructures considérables, réparties dans de nombreux centres de données. Cette redondance permet de résister à de nombreuses défaillances matérielles, mais elle ne supprime pas les dépendances entre les composants.
Un problème affectant un service partagé, une configuration déployée simultanément sur de nombreuses machines ou un mécanisme de surveillance peut provoquer des perturbations beaucoup plus étendues qu’une simple panne de serveur.
La difficulté n’est donc pas uniquement de posséder suffisamment de machines. Elle consiste à garantir que les systèmes chargés de les coordonner prennent les bonnes décisions, même lorsqu’une partie de l’infrastructure rencontre des difficultés.
7. Comment éviter ces réactions en chaîne ?
Les ingénieurs cherchent à limiter ces risques en utilisant plusieurs indicateurs de santé, en surveillant la capacité restante et en évitant de retirer simultanément trop de serveurs. Les changements de configuration sont également déployés progressivement afin de détecter les anomalies avant qu’elles n’affectent toute une infrastructure.
Des mécanismes de protection, comme les limites de retrait automatique, les délais entre contrôles et les stratégies de réduction de charge, peuvent empêcher qu’une défaillance locale provoque une réaction disproportionnée.
Ces protections ne garantissent pas une disponibilité absolue, mais elles réduisent considérablement le risque qu’une erreur technique se transforme en panne généralisée.
Conclusion : le cloud peut être victime de ses propres mécanismes de protection
Les grandes plateformes informatiques sont conçues pour détecter les problèmes et réagir automatiquement. C’est précisément cette automatisation qui leur permet de fonctionner à une échelle aussi importante. Mais lorsqu’un contrôle se trompe, lorsqu’une dépendance commune devient indisponible ou lorsque les mécanismes de protection interagissent mal, le système peut contribuer à amplifier l’incident qu’il devait contenir.
C’est tout le paradoxe des infrastructures modernes : un serveur n’a pas besoin d’être éteint pour être considéré comme malade, et une panne n’a pas besoin de toucher toutes les machines pour rendre un service indisponible.
Ce scénario explique un mécanisme possible de panne dans le cloud, sans constituer une attribution technique de la dernière panne de Microsoft. Pour connaître la cause exacte d’un incident, il faut se référer à son rapport d’analyse officiel.